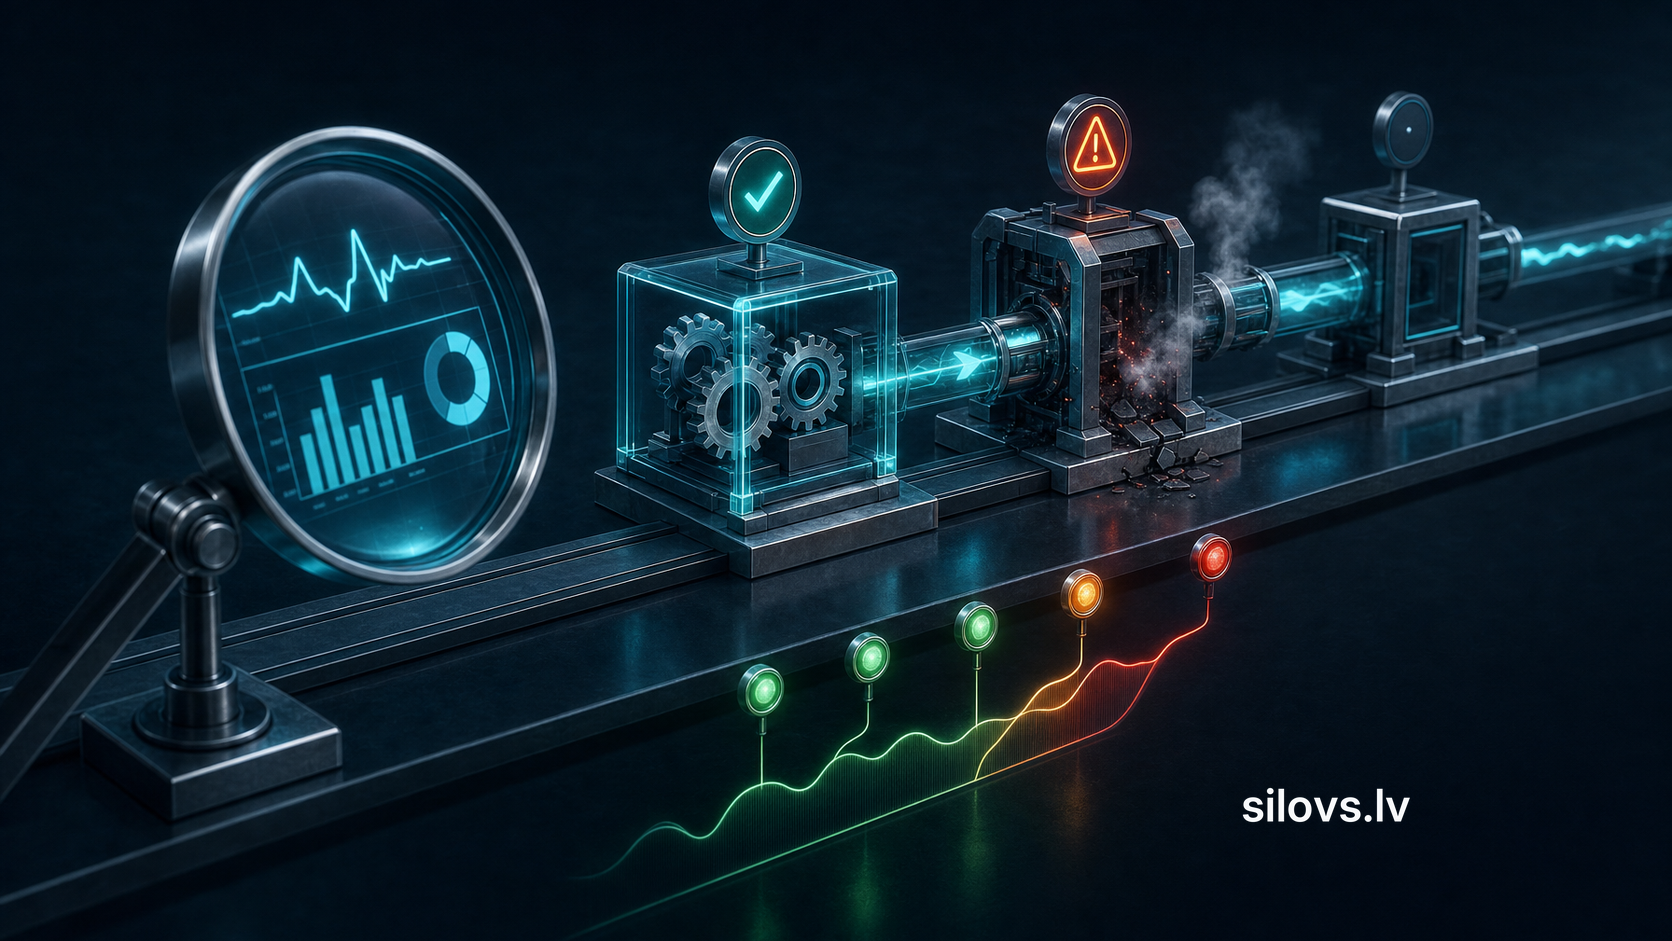
Мониторинг автоматизации должен показывать две вещи: работает ли система технически и завершается ли работа правильно, вовремя и без растущего ручного вмешательства. Самыми ранними признаками деградации обычно становятся увеличение времени выполнения, старение очереди, учащение повторных попыток, ухудшение качества данных и отклонение объёма обработки от ожидаемого. Доля ошибок и недостигнутый бизнес-результат часто уже подтверждают наличие проблемы. Поэтому практичная система мониторинга объединяет технические KPI, показатели рабочего процесса и бизнес-KPI, устанавливает для них контекстные пороги и связывает каждое существенное оповещение с конкретным ответственным лицом и планом действий.
Что означает деградация рабочего процесса
Автоматизация может быть нарушена, даже если её статус — «работает». Запросы по-прежнему поступают, и часть запусков завершается успешно, однако результаты приходят всё позже, количество необработанных единиц растёт или система начинает принимать неполные данные. В такой ситуации ждать полного отказа уже слишком поздно.
Мониторинг должен охватывать три взаимосвязанных уровня:
- Техническое выполнение — отвечают ли сервисы, соединения, задачи и внешние зависимости.
- Состояние рабочего процесса — проходят ли единицы через все этапы без роста очереди, задержек и повторной обработки.
- Бизнес-результат — создан ли правильный счёт, отправлена ли заявка, обновлён ли статус или достигнута иная цель процесса.
Если измерять только первый уровень, можно не заметить семантическую ошибку: API возвращает успешный статус, но поле содержит неверное значение. Если измерять только бизнес-результат, проблема становится видна слишком поздно. Поэтому нужны как ранние показатели, так и показатели, подтверждающие результат.
KPI, выявляющие деградацию автоматизации
Подход Google SRE к мониторингу выделяет в качестве отправной точки задержку, трафик, ошибки и насыщение. Для автоматизированного бизнес-процесса одних этих технических сигналов недостаточно, но они помогают структурировать измерения. Практический набор KPI следует дополнить показателями очереди, качества данных и бизнес-результата.
|
KPI |
Что он показывает |
Что может означать отклонение |
|
Доля успешно завершённых запусков |
Сколько единиц достигает предусмотренного конечного статуса |
Ошибку интеграции, валидации или бизнес-правил |
|
Время выполнения |
Сколько времени единица проходит путь от запуска до результата |
Медленную зависимость, заблокированный этап или нехватку ресурсов |
|
Объём обработки |
Сколько единиц обработано за определённый период |
Прекращение поступления данных или снижение пропускной способности системы |
|
Длина очереди и возраст самой старой единицы |
Накапливается ли работа и как долго она ожидает |
Скорость обработки отстаёт от входящего потока |
|
Доля повторных попыток |
Как часто действие не удаётся выполнить с первой попытки |
Нестабильность внешних сервисов или проблемы с ограничениями по времени |
|
Количество необратимых ошибок, или элементов dead-letter |
Сколько единиц больше не обрабатывается автоматически |
Необходимость ручного расследования или исправления данных |
|
Ошибки валидации данных |
Соответствуют ли входные данные ожидаемой структуре и правилам |
Изменения в исходной системе или некачественные входные данные |
|
Доля ручного перехвата |
Как часто человеку приходится завершать автоматизированный процесс |
Рост числа неполных правил, исключений или проявлений деградации |
|
Количество дубликатов и расхождений при сверке |
Сохраняется ли в системах один и тот же результат |
Проблемы повторных вызовов, идемпотентности или синхронизации |
|
Доля достигнутых бизнес-результатов |
Приводит ли технически завершённое действие к нужному результату |
Скрытую семантическую ошибку, которую не выявляет технический статус |
Не каждую метрику нужно сразу превращать в оповещение. Одни KPI предназначены для анализа тенденций, а другие указывают на инцидент, требующий действий. Например, одна повторная попытка может быть нормальной защитой от кратковременной ошибки соединения. Продолжительный рост числа повторов вместе со старением очереди уже говорит о том, что поток не может восстановиться.
Измеряйте распределение, а не только среднее значение
Среднее время выполнения может скрывать небольшую, но важную для бизнеса группу очень медленных единиц. Поэтому наряду со средним показателем нужно оценивать процентили или хотя бы разделять обычные и чрезвычайно долгие выполнения. Сегментация также нужна по типу процесса, группе клиентов, интеграции, источнику данных и категории ошибки, если такое разделение обосновано с точки зрения бизнеса.
Статус успешного выполнения тоже необходимо точно определить. Если заявка записана в базу данных, но не попала в CRM или не была назначена ответственному, технически завершённый промежуточный этап ещё не является бизнес-успехом. Итоговый KPI должен быть связан с проверяемым результатом, а не с наиболее удобным системным событием.
В процессах с малым объёмом процентные показатели могут вводить в заблуждение: одна ошибка резко меняет долю. В таком случае проценты следует рассматривать вместе с абсолютным количеством единиц, продолжительностью ожидания и значимостью конкретной единицы.
Как устанавливать содержательные пороги оповещений
Универсального порога для ошибок или времени выполнения не существует. Он зависит от критичности процесса для бизнеса, обычной вариативности, сезонности, объёма данных и времени, за которое команда ещё может предотвратить ущерб. Хороший порог отделяет нормальное колебание от состояния, требующего решения.
Начните с исторического базового уровня за периоды нормальной работы. Отдельно оцените рабочие дни, ночные задания, конец месяца и другие предсказуемые режимы нагрузки. Затем определите:
- ожидаемый диапазон, не требующий реакции;
- состояние предупреждения, при котором тенденцию нужно исследовать до того, как пострадает результат;
- критическое состояние, при котором возможен ущерб для клиентов, финансов, данных или сроков;
- условие восстановления, показывающее, когда инцидент действительно завершён.
Статический порог подходит для стабильного потока с чёткой границей: например, единица не должна ожидать дольше установленного бизнес-срока. Динамический порог лучше подходит для переменного объёма, однако он может принять медленную деградацию за новую норму. Поэтому динамическое обнаружение аномалий не следует использовать без абсолютной бизнес-границы.
Для периодического задания также требуется оповещение об отсутствии события. Если ночной импорт вообще не запускается, доля ошибок может остаться нулевой, поскольку запусков не было. Такую проблему выявляет отсутствие ожидаемого события запуска, завершения или heartbeat.
Хорошее оповещение объясняет, что делать
Оповещение не должно просто повторять значение метрики. Оно должно предоставлять достаточно контекста, чтобы ответственный мог определить масштаб проблемы и первую необходимую проверку. Практическое уведомление включает:
- название рабочего процесса и среды;
- затронутый этап и наблюдаемый симптом;
- время начала отклонения и его продолжительность;
- количество затронутых или ожидающих в очереди единиц;
- время последнего успешного выполнения;
- ссылку на панель, журнал или инструкцию по расследованию;
- ответственную роль и порядок эскалации.
Информационное уведомление может попасть в отчёт. Предупреждение требует проверки в установленный рабочий период. Критическое уведомление должно активировать немедленную реакцию только тогда, когда задержка создаёт существенный риск. Если все сигналы критические, команда привыкает к шуму и может пропустить действительно важный инцидент.
Рекомендации Prometheus по оповещениям советуют сосредоточиться на симптомах, заметных пользователю или сервису, а не создавать уведомление для каждой возможной технической причины. В автоматизации это означает, что возраст очереди или недостигнутый результат часто служат более ценным сигналом, чем отдельная кратковременная ошибка соединения.
Какие данные нужны для диагностики
Метрика показывает, что что-то изменилось; журнал помогает понять конкретное событие; трассировка показывает путь единицы через несколько сервисов. В модели наблюдаемости OpenTelemetry метрики, журналы и трассировки являются взаимодополняющими телеметрическими сигналами. События бизнес-процесса нужно добавлять к ним осознанно, поскольку технический инструмент сам не знает, что для компании означает «завершено правильно».
Для каждой обрабатываемой единицы необходимы идентификатор корреляции, статус этапа, время начала и завершения, категория ошибки и номер попытки обработки. Желательно также регистрировать версию правила или интеграции, чтобы после изменений можно было отделить новое поведение от предыдущего.
Не следует бесконтрольно копировать в журналы полные документы клиентов, учётные данные доступа и другую конфиденциальную информацию. Для диагностики обычно достаточно идентификаторов, статусов и безопасно отобранных полей. Доступ к данным мониторинга нужно ограничивать с учётом их содержимого.
Пример: передача заявки клиента в CRM
Предположим, форма на сайте проверяет заявку, создаёт контакт в CRM, назначает ответственного и отправляет подтверждение. Одной метрики «форма работает» недостаточно.
Ранними сигналами будут увеличение времени выполнения запросов к CRM, частота повторных попыток и возраст очереди заявок. KPI результата проверит, создана ли для каждой корректной заявки с формы за установленное время ровно одна запись в CRM, назначен ли владелец и зарегистрирован ли статус подтверждения. Проверка сверки сопоставит заявки, принятые формой, с записями, созданными в CRM.
Если CRM временно недоступна, повторная попытка сама по себе ещё не является инцидентом. Если очередь продолжает стареть или появляются необратимо отклонённые единицы, следует уведомить владельца процесса. Если повторы могут привести к созданию нескольких контактов, мониторинг необходимо дополнить контролем идемпотентности и проверкой дубликатов. В свою очередь, требуемые при ошибке ручные действия относятся к проектированию резервного процесса, а не только к мониторингу.
Панель мониторинга должна помогать принимать решения
Не нужно помещать в один экран все доступные метрики. Оперативная панель должна отвечать на четыре вопроса: работает ли поток сейчас, накапливается ли работа, какие этапы затронуты и достигается ли бизнес-результат. Представление тенденций должно дополнительно показывать изменения в категориях ошибок, объёме ручной работы, качестве данных и времени обработки.
Общий зелёный статус не должен скрывать критический сегмент. Если нарушена одна интеграция или конкретный вид работы, панель должна позволять отделить его от остального потока. При этом количество сегментов должно оставаться управляемым, иначе в каждом из них окажется слишком мало данных, а отчёт станет трудно интерпретировать.
Последовательность внедрения
- Назовите результат процесса. Определите, что именно подтверждает успешное завершение и насколько результат может задержаться.
- Разделите поток на этапы. Для каждого этапа укажите вход, выход, зависимость, ответственного и возможные исключения.
- Внедрите регистрацию событий. Добавьте идентификаторы корреляции, временные метки, статусы и категории ошибок.
- Создайте базовый уровень. Наблюдайте за нормальной работой в разных режимах нагрузки, прежде чем устанавливать жёсткие пороги.
- Выберите небольшой набор критических KPI. Включите как минимум результат, время выполнения, состояние очереди, ошибки и ручной перехват.
- Свяжите оповещения с действиями. Укажите ответственную роль, первые проверки, порядок эскалации и резервный ручной путь.
- Проверьте мониторинг. Контролируемо смоделируйте недоступность зависимости, некорректные данные, застрявшую очередь и невыполненное периодическое задание.
- Пересматривайте качество сигналов. Оценивайте, какие уведомления привели к действиям, какие создавали шум и какие инциденты система не заметила.
Мониторинг — не однажды настроенная панель. При изменении правил процесса, интеграций или бизнес-сроков нужно пересматривать определения показателей и их пороги.
Ограничения и риски
Данные мониторинга не могут компенсировать нечёткое определение процесса. Если нет согласованного понимания правильного результата, точные технические показатели лишь подробно опишут неясную систему.
Исторический базовый уровень может вводить в заблуждение после существенных изменений в бизнесе или технологиях. Сезонность и малые объёмы данных создают ложные аномалии, а медленная деградация может не превысить динамический порог. В то же время слишком чувствительные уведомления вызывают усталость от оповещений.
Не все ошибки видны в инфраструктурных данных. Неверно рассчитанная сумма, ошибочно присвоенный статус или отправка не тому получателю могут технически завершиться без ошибки. Для таких рисков необходимы бизнес-валидация, проверки сверки, а иногда и выборочный контроль качества.
KPI также могут стимулировать нежелательное поведение. Команда может улучшить среднее время выполнения, откладывая более сложные случаи, или снизить долю ошибок, переклассифицируя неудачи. Поэтому показатели скорости нужно рассматривать вместе с качеством, отложенной работой и конечным результатом.
Краткий контрольный список для владельца процесса
- Определён ли проверяемый конечный бизнес-результат?
- Видны ли количество ошибок, возраст очереди и время выполнения?
- Можно ли проследить путь одной единицы через все этапы?
- Создаёт ли сигнал отсутствие запуска периодического задания?
- Есть ли у оповещения ответственный, приоритет и инструкция по действиям?
- Основаны ли критические пороги на влиянии на бизнес, а не на удобном круглом числе?
- Отслеживаются ли дубликаты, расхождения и ручной перехват?
- Не хранятся ли в журналах без необходимости конфиденциальные данные?
- Пересматриваются ли KPI и пороги после изменений процесса?
Связанные следующие вопросы
Создание мониторинга тесно связано с картированием процесса, обработкой ошибок и идемпотентностью. Поэтому эту тему логично дополняют статьи «Картирование бизнес-процесса перед автоматизацией», «Что происходит, если автоматизация ошибается: как спроектировать обработку ошибок и резервный ручной процесс» и «Идемпотентность в интеграциях: как не допустить дублирования счетов и заказов». Каждая из них отвечает на отдельный вопрос: что измерять, как действовать после ошибки и как предотвратить ущерб от повторной обработки.
Заключение
Полезный мониторинг автоматизации начинается с бизнес-результата и движется в обратном направлении — к техническим сигналам. Для раннего выявления проблемы обычно наиболее ценна комбинация нескольких признаков: растёт время выполнения, стареет очередь, чаще требуются повторные попытки и снижается доля правильно завершённых единиц. Оповещение становится ценным только тогда, когда оно своевременно, понятно и связано с конкретным действием. Сигнал должен поступить достаточно рано, чтобы процесс можно было восстановить до возникновения существенного ущерба. Сбор максимально возможного количества метрик не является самоцелью.