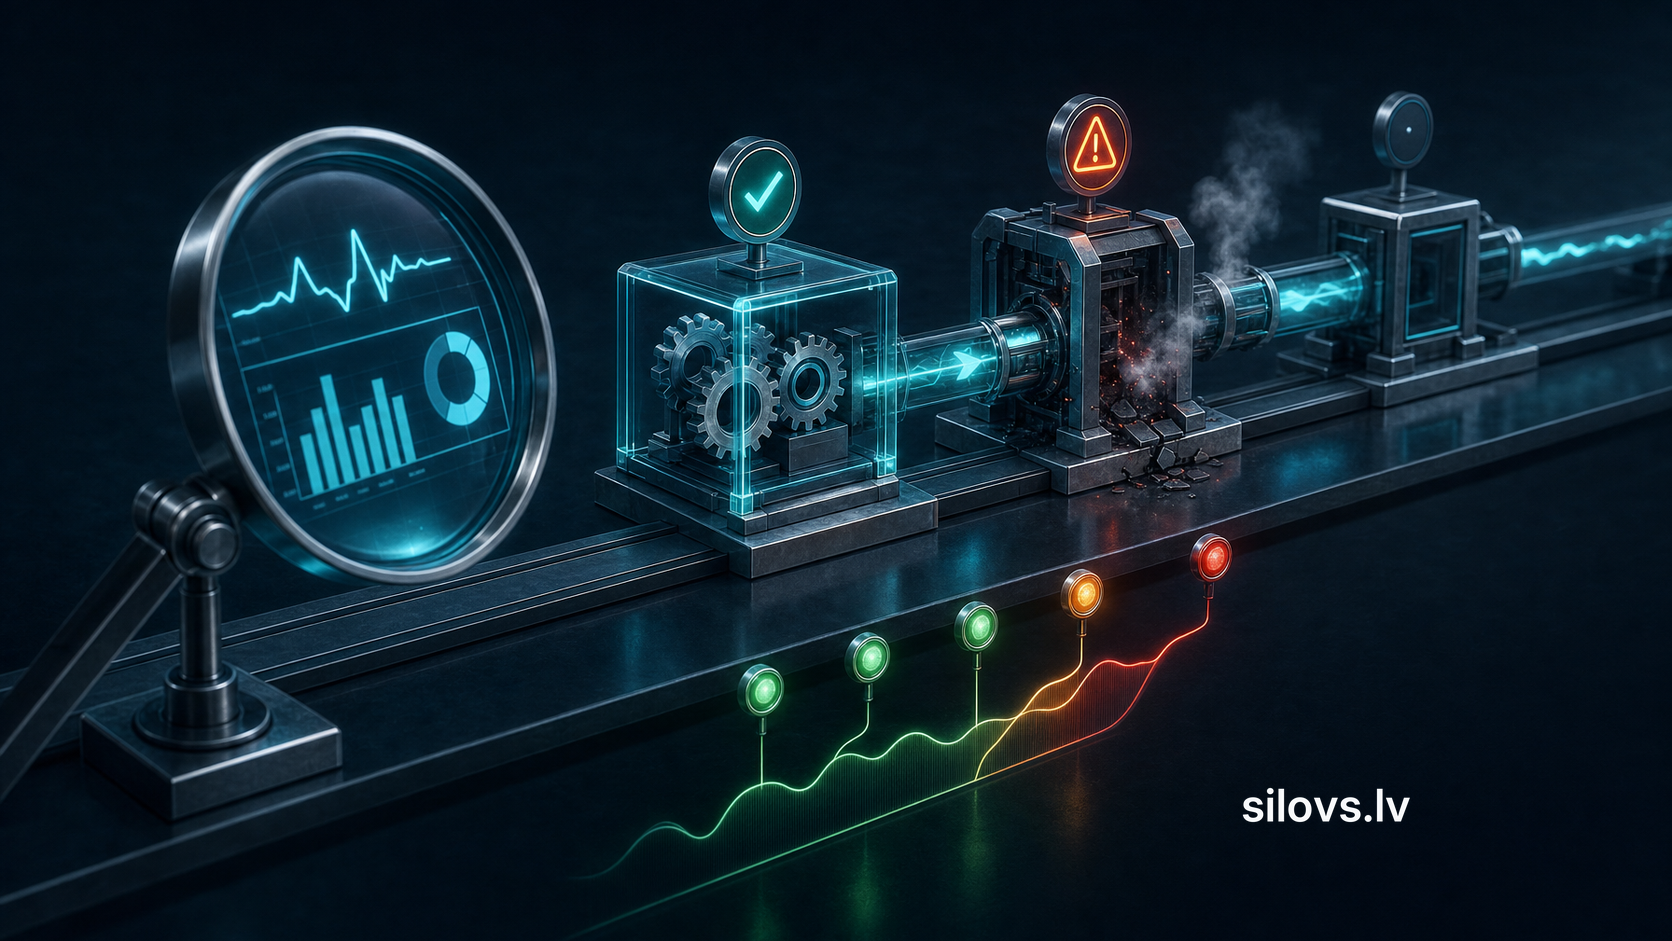
Automatizācijas uzraudzībai jāparāda divas lietas: vai sistēma tehniski darbojas un vai darbs tiek pabeigts pareizi, paredzētajā laikā un bez pieaugošas manuālas iejaukšanās. Agrīnākie bojāšanās signāli parasti ir izpildes laika pieaugums, novecojoša rinda, biežāki atkārtoti mēģinājumi, datu kvalitātes kritums un novirze no gaidītā apstrādes apjoma. Savukārt kļūdu īpatsvars un neizpildīts biznesa rezultāts bieži jau apstiprina problēmu. Praktiska uzraudzības sistēma tāpēc apvieno tehniskos, darba plūsmas un biznesa KPI, nosaka tiem kontekstuālus sliekšņus un katru būtisku brīdinājumu piesaista konkrētam atbildīgajam un rīcības plānam.
Ko nozīmē, ka darba plūsma sāk bojāties
Automatizācija var būt degradēta arī tad, ja tās statuss ir “darbojas”. Pieprasījumi joprojām tiek saņemti un daļa izpildes reižu beidzas veiksmīgi, tomēr rezultāti pienāk arvien vēlāk, palielinās neapstrādāto vienību skaits vai sistēma sāk pieņemt nepilnīgus datus. Šādā situācijā gaidīt pilnīgu atteici ir par vēlu.
Uzraudzībai jāaptver trīs savstarpēji saistīti līmeņi:
- Tehniskā izpilde — vai servisi, savienojumi, uzdevumi un ārējās atkarības atbild.
- Darba plūsmas veselība — vai vienības pārvietojas cauri visiem posmiem bez rindas, kavēšanās un atkārtotas apstrādes pieauguma.
- Biznesa rezultāts — vai izveidots pareizais rēķins, nosūtīts pieteikums, atjaunots statuss vai izpildīta cita procesa jēga.
Ja tiek mērīts tikai pirmais līmenis, var nepamanīt semantisku kļūdu: API atbild ar veiksmīgu statusu, taču laukā ir nepareiza vērtība. Mērot tikai biznesa rezultātu, problēma kļūst redzama novēloti. Tāpēc vajadzīgi gan agrīnie, gan rezultātu apstiprinošie rādītāji.
KPI, kas atklāj automatizācijas degradāciju
Google SRE uzraudzības pieeja kā sākumpunktu izceļ latentumu, datplūsmu, kļūdas un piesātinājumu. Automatizētā biznesa procesā ar šiem tehniskajiem signāliem vien nepietiek, tomēr tie palīdz strukturēt mērījumus. Praktiskā KPI kopa jāpapildina ar rindas, datu kvalitātes un biznesa iznākuma rādītājiem.
|
KPI |
Ko tas parāda |
Ko var nozīmēt novirze |
|
Veiksmīgi pabeigto izpildes reižu īpatsvars |
Cik vienību sasniedz paredzēto gala statusu |
Integrācijas, validācijas vai biznesa noteikumu kļūdu |
|
Izpildes laiks |
Cik ilgi vienība ceļo no sākuma līdz rezultātam |
Lēnu atkarību, bloķētu posmu vai resursu trūkumu |
|
Apstrādes apjoms |
Cik vienību apstrādātas noteiktā periodā |
Ievades pārtraukumu vai samazinātu sistēmas caurlaidību |
|
Rindas garums un vecākās vienības vecums |
Vai darbs uzkrājas un cik ilgi gaida |
Patēriņa ātrums atpaliek no ienākošās plūsmas |
|
Atkārtotu mēģinājumu īpatsvars |
Cik bieži darbība neizdodas ar pirmo mēģinājumu |
Nestabilu ārējo servisu vai laika ierobežojumu problēmu |
|
Neatgriezenisko kļūdu jeb dead-letter vienību skaits |
Cik vienību automātiski vairs netiek apstrādātas |
Nepieciešamu manuālu izmeklēšanu vai datu labošanu |
|
Datu validācijas kļūdas |
Vai ievades dati atbilst sagaidītajai struktūrai un noteikumiem |
Avota sistēmas izmaiņas vai nekvalitatīvu ievadi |
|
Manuālās pārņemšanas īpatsvars |
Cik bieži cilvēkam jāpabeidz automātiskais process |
Nepilnīgu noteikumu, izņēmumu vai degradācijas pieaugumu |
|
Dublikātu un saskaņošanas neatbilstību skaits |
Vai sistēmās saglabājas viens un tas pats rezultāts |
Atkārtotu izsaukumu, idempotences vai sinhronizācijas problēmu |
|
Biznesa rezultāta īpatsvars |
Vai tehniski pabeigta darbība rada vajadzīgo iznākumu |
Klusu semantisku kļūdu, ko tehniskais statuss neatklāj |
Nav nepieciešams katru metriku pārvērst tūlītējā brīdinājumā. Daļa KPI ir paredzēta tendences analīzei, bet citi norāda uz incidentu, kas prasa rīcību. Piemēram, viens atkārtots mēģinājums var būt normāla aizsardzība pret īslaicīgu savienojuma kļūdu. Ilgstošs atkārtojumu pieaugums kopā ar rindas novecošanu jau liecina, ka plūsma nespēj atgūties.
Mēriet sadalījumu, ne tikai vidējo vērtību
Vidējais izpildes laiks var slēpt nelielu, bet biznesam svarīgu ļoti lēnu vienību grupu. Tāpēc līdzās vidējam rādītājam jāvērtē procentiles vai vismaz jānodala parastās un ārkārtīgi ilgās izpildes. Segmentēšana ir vajadzīga arī pēc procesa veida, klientu grupas, integrācijas, datu avota un kļūdas kategorijas, ja šāds dalījums ir biznesam pamatots.
Arī veiksmīgas izpildes statuss jādefinē precīzi. Ja pieteikums ir ierakstīts datubāzē, bet nav nonācis CRM vai nav piešķirts atbildīgajam, tehniskais starpposms nav biznesa panākums. Gala KPI jābūt piesaistītam pārbaudāmam rezultātam, nevis ērtākajam sistēmas notikumam.
Zema apjoma procesos procentu rādītāji var būt maldinoši: viena kļūda krasi maina īpatsvaru. Šādā gadījumā procenti jāskata kopā ar absolūto vienību skaitu, gaidīšanas ilgumu un konkrētās vienības nozīmīgumu.
Kā noteikt jēgpilnus brīdinājumu sliekšņus
Universāls kļūdu vai izpildes laika slieksnis nepastāv. To nosaka procesa biznesa kritiskums, parastā mainība, sezonalitāte, datu apjoms un laiks, kurā komanda vēl var novērst kaitējumu. Labs slieksnis atdala normālu svārstību no stāvokļa, kurā nepieciešams lēmums.
Sāciet ar vēsturisko pamatlīniju normālos darbības periodos. Atsevišķi novērtējiet darba dienas, nakts uzdevumus, mēneša beigas un citus paredzamus apjoma režīmus. Pēc tam definējiet:
- gaidīto diapazonu, kas neprasa reakciju;
- brīdinājuma stāvokli, kurā tendence jāizpēta, pirms cieš rezultāts;
- kritisko stāvokli, kurā iespējams klientu, finanšu, datu vai termiņa kaitējums;
- atjaunošanās nosacījumu, kas pasaka, kad incidents tiešām ir beidzies.
Statisks slieksnis der stabilai plūsmai ar skaidru robežu, piemēram, vienība nedrīkst gaidīt ilgāk par noteikto biznesa termiņu. Dinamisks slieksnis ir piemērotāks mainīgam apjomam, taču tas var pieņemt lēnu degradāciju par jauno normu. Tāpēc dinamisku anomāliju noteikšanu nevajadzētu izmantot bez absolūtas biznesa robežas.
Periodiskam uzdevumam vajadzīgs arī neesamības brīdinājums. Ja nakts imports vispār nesākas, kļūdu īpatsvars var palikt nulle, jo nav nevienas izpildes. Šādu problēmu atklāj gaidītā sākuma, pabeigšanas vai heartbeat notikuma trūkums.
Labs brīdinājums pasaka, ko darīt
Brīdinājumam nevajadzētu tikai atkārtot metriku. Tam jāsniedz pietiekams konteksts, lai atbildīgais varētu noteikt problēmas apmēru un pirmo pārbaudi. Praktiskā paziņojumā iekļauj:
- darba plūsmas un vides nosaukumu;
- skarto posmu un novēroto simptomu;
- novirzes sākuma laiku un ilgumu;
- skarto vai rindā gaidošo vienību apjomu;
- pēdējās veiksmīgās izpildes laiku;
- saiti uz paneli, žurnālu vai izmeklēšanas instrukciju;
- atbildīgo lomu un eskalācijas kārtību.
Informatīvs paziņojums var nonākt pārskatā. Brīdinājums prasa pārbaudi noteiktā darba periodā. Kritiskam paziņojumam jāaktivizē tūlītēja reakcija tikai tad, ja kavēšanās rada būtisku risku. Ja visi signāli ir kritiski, komanda pierod pie trokšņa un var nepamanīt patiesi svarīgo incidentu.
Prometheus brīdinājumu vadlīnijas iesaka koncentrēties uz lietotājam vai pakalpojumam redzamiem simptomiem, nevis veidot paziņojumu par katru iespējamo tehnisko cēloni. Automatizācijā tas nozīmē, ka rindas vecums vai neizpildīts rezultāts bieži ir vērtīgāks signāls par atsevišķu īslaicīgu savienojuma kļūdu.
Kādi dati vajadzīgi diagnozei
Metrika pasaka, ka kaut kas mainījies; žurnāls palīdz saprast konkrētu notikumu; izsekošana parāda vienības ceļu cauri vairākiem servisiem. OpenTelemetry observability modelī metrikas, žurnāli un traces ir savstarpēji papildinoši telemetrijas signāli. Biznesa procesa notikumi tiem jāpievieno apzināti, jo tehniskais rīks pats nezina, ko uzņēmumam nozīmē “pareizi pabeigts”.
Katrai apstrādes vienībai nepieciešams korelācijas identifikators, posma statuss, sākuma un beigu laiks, kļūdas kategorija un apstrādes mēģinājuma numurs. Vēlams reģistrēt arī noteikuma vai integrācijas versiju, lai pēc izmaiņām varētu nodalīt jaunu uzvedību no iepriekšējās.
Žurnālos nevajag nekontrolēti kopēt pilnus klientu dokumentus, piekļuves pilnvaras vai citus sensitīvus datus. Diagnozei parasti pietiek ar identifikatoriem, statusiem un droši atlasītiem laukiem. Piekļuve uzraudzības datiem jāierobežo atbilstoši to saturam.
Piemērs: klienta pieteikuma nodošana CRM
Pieņemsim, ka mājaslapas forma validē pieteikumu, izveido kontaktu CRM, piešķir atbildīgo un nosūta apstiprinājumu. Ar vienu metriku “forma darbojas” nepietiek.
Agrīnie signāli būtu CRM pieprasījumu izpildes laika pieaugums, atkārtotu mēģinājumu biežums un pieteikumu rindas vecums. Rezultāta KPI pārbaudītu, vai katram derīgam formas pieteikumam noteiktajā laikā ir izveidots tieši viens CRM ieraksts, piešķirts īpašnieks un reģistrēts apstiprinājuma statuss. Saskaņošanas pārbaude salīdzinātu formas pieņemtos pieteikumus ar CRM izveidotajiem ierakstiem.
Ja CRM īslaicīgi nav pieejams, atkārtots mēģinājums pats par sevi vēl nav incidents. Ja rinda turpina novecot vai rodas neatgriezeniski noraidītas vienības, jābrīdina procesa īpašnieks. Ja atkārtojumi var radīt vairākus kontaktus, uzraudzība jāpapildina ar idempotences kontroli un dublikātu pārbaudi. Savukārt kļūdas gadījumā nepieciešamā manuālā rīcība pieder rezerves procesa projektēšanai, nevis tikai uzraudzībai.
Vadības panelim jāatbalsta lēmums
Vienā skatā nav jāievieto visas pieejamās metrikas. Operatīvajam panelim jāatbild uz četriem jautājumiem: vai plūsma šobrīd strādā, vai darbs uzkrājas, kuri posmi ir skarti un vai tiek sasniegts biznesa rezultāts. Tendences skatam papildus jāparāda izmaiņas kļūdu kategorijās, manuālajā darbā, datu kvalitātē un apstrādes laikā.
Kopējais zaļais statuss nedrīkst noslēpt kritisku segmentu. Ja viena integrācija vai konkrēts darba veids ir bojāts, panelī jābūt iespējai to atdalīt no pārējās plūsmas. Vienlaikus segmentu skaitam jāpaliek pārvaldāmam, citādi katram būs pārāk maz datu un pārskats kļūs grūti interpretējams.
Ieviešanas secība
- Nosauciet procesa rezultātu. Definējiet, kas tieši apliecina veiksmīgu pabeigšanu un cik ilgi rezultāts drīkst kavēties.
- Sadaliet plūsmu posmos. Katram posmam norādiet ieeju, izeju, atkarību, atbildīgo un iespējamos izņēmumus.
- Ieviesiet notikumu reģistrēšanu. Pievienojiet korelācijas identifikatorus, laika zīmogus, statusus un kļūdu kategorijas.
- Izveidojiet pamatlīniju. Novērojiet normālu darbu dažādos apjoma režīmos, pirms nosakāt agresīvus sliekšņus.
- Izvēlieties nelielu kritisko KPI kopu. Iekļaujiet vismaz rezultātu, izpildes laiku, rindas veselību, kļūdas un manuālo pārņemšanu.
- Piesaistiet brīdinājumiem rīcību. Norādiet atbildīgo lomu, pirmās pārbaudes, eskalāciju un manuālo rezerves ceļu.
- Pārbaudiet uzraudzību. Kontrolēti simulējiet atkarības nepieejamību, nekorektus datus, iestrēgušu rindu un neizpildītu periodisku uzdevumu.
- Pārskatiet signālu kvalitāti. Vērtējiet, kuri paziņojumi radīja rīcību, kuri bija troksnis un kurus incidentus sistēma nepamanīja.
Uzraudzība nav vienreiz uzstādīts panelis. Mainot procesa noteikumus, integrācijas vai biznesa termiņus, jāpārskata arī mērījumu definīcijas un sliekšņi.
Ierobežojumi un riski
Uzraudzības dati nevar kompensēt neskaidru procesa definīciju. Ja nav vienošanās, kas ir pareizs rezultāts, precīzi tehniskie mērījumi tikai detalizēti aprakstīs neskaidru sistēmu.
Vēsturiskā pamatlīnija var būt maldinoša pēc būtiskām biznesa vai tehnoloģijas izmaiņām. Sezonalitāte un mazi datu apjomi rada viltus anomālijas, bet lēna degradācija var nepārsniegt dinamisku slieksni. Savukārt pārāk jutīgi paziņojumi rada brīdinājumu nogurumu.
Ne visas kļūdas ir redzamas infrastruktūras datos. Nepareizi aprēķināta summa, kļūdaini piešķirts statuss vai nosūtījums nepareizam saņēmējam var tehniski izpildīties bez kļūdas. Šādiem riskiem vajadzīgas biznesa validācijas, saskaņošanas pārbaudes un reizēm izlases kvalitātes kontrole.
Arī KPI var veicināt nevēlamu uzvedību. Komanda var uzlabot vidējo izpildes laiku, atliekot sarežģītākos gadījumus, vai samazināt kļūdu īpatsvaru, pārklasificējot neveiksmes. Tāpēc ātruma rādītāji jāskata kopā ar kvalitāti, atlikto darbu un gala rezultātu.
Īss kontrolsaraksts procesa īpašniekam
- Vai ir definēts pārbaudāms biznesa gala rezultāts?
- Vai redzams kļūdu skaits, rindas vecums un izpildes laiks?
- Vai iespējams atrast vienas vienības ceļu cauri visiem posmiem?
- Vai periodiska uzdevuma nepalaišana rada signālu?
- Vai brīdinājumam ir atbildīgais, prioritāte un rīcības instrukcija?
- Vai kritiskie sliekšņi balstīti biznesa ietekmē, nevis ērtā apaļā skaitlī?
- Vai tiek uzraudzīti dublikāti, neatbilstības un manuālā pārņemšana?
- Vai žurnālos netiek nevajadzīgi glabāti sensitīvi dati?
- Vai pēc procesa izmaiņām tiek pārskatīti KPI un sliekšņi?
Saistītie nākamie jautājumi
Uzraudzības izveide ir cieši saistīta ar procesa kartēšanu, kļūdu apstrādi un idempotenci. Tāpēc šo tēmu loģiski papildina raksti “Biznesa procesa kartēšana pirms automatizācijas”, “Kas notiek, ja automatizācija kļūdās: kā projektēt kļūdu apstrādi un manuālu rezerves procesu” un “Idempotence integrācijās: kā nepieļaut dubultus rēķinus un pasūtījumus”. Katrs risina citu jautājumu: ko mērīt, kā rīkoties pēc kļūdas un kā novērst atkārtotas apstrādes kaitējumu.
Secinājums
Noderīga automatizācijas uzraudzība sākas ar biznesa rezultātu un virzās atpakaļ līdz tehniskajiem signāliem. Agrīnai problēmas atklāšanai visvērtīgākā parasti ir vairāku pazīmju kombinācija: pieaug izpildes laiks, noveco rinda, biežāk vajadzīgi atkārtojumi un samazinās pareizi pabeigto vienību īpatsvars. Brīdinājums kļūst vērtīgs tikai tad, ja tas ir savlaicīgs, izskaidrojams un piesaistīts konkrētai rīcībai. Vajadzīgs pietiekami agrs signāls, lai procesu varētu atjaunot pirms būtiska kaitējuma. Pēc iespējas vairāk metriku savākšana nav pašmērķis.